Jetson Orin NX Super(16GB)で、ローカルLLMがどのサイズまで実用速度で動くのかを実測しました。同世代でメモリ容量だけが違う8GBのOrin Nano Superと比べると、差が出るのは「大きいモデルが載るか」です。この記事は2026-09-14に本サイトが実測した11モデル(ollama 0.34.0・MAXN_SUPER)を根拠にまとめています。機材単体の全数値はOrin NX Superのベンチ一覧、他機材との横並びは比較ツールで確認できます。
結論
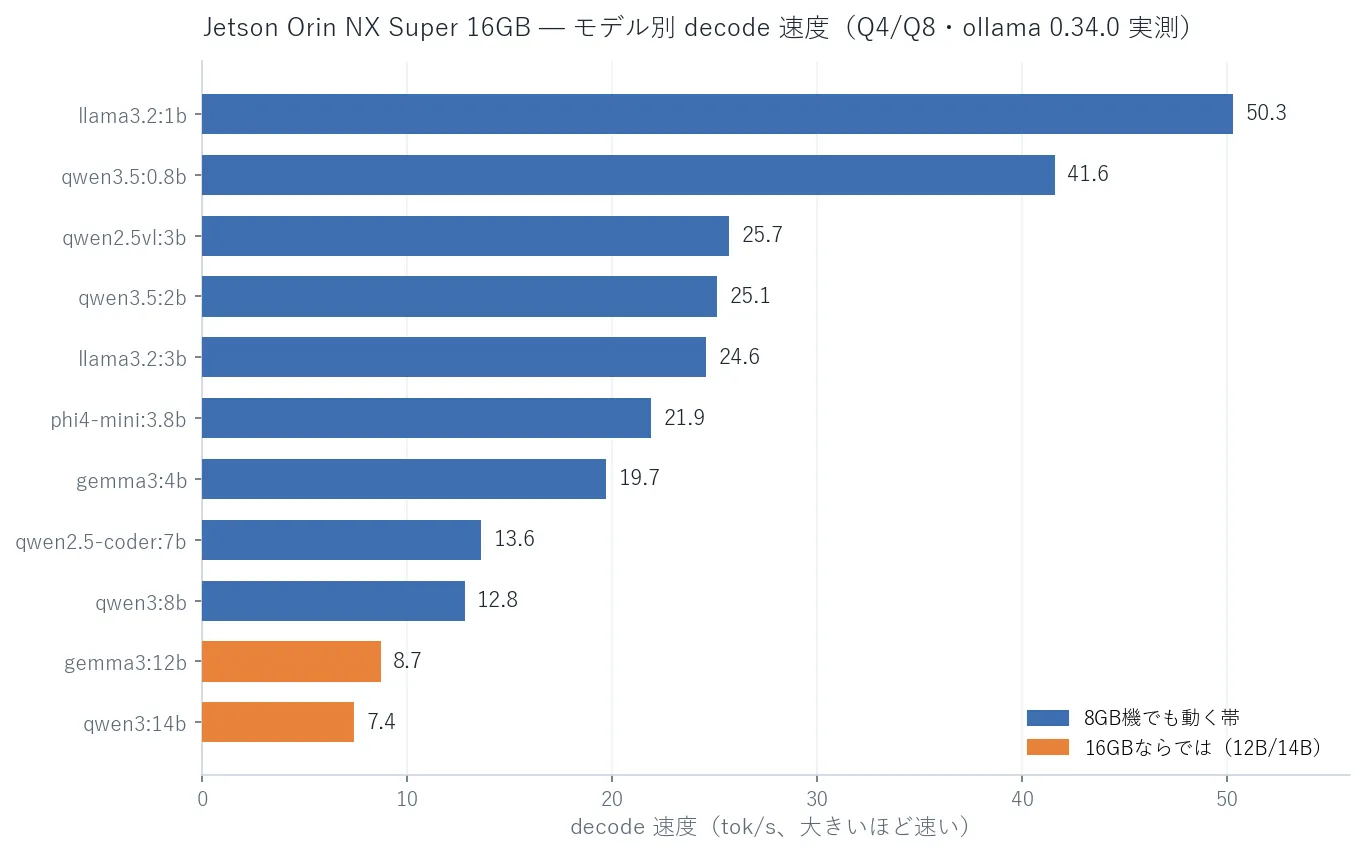
- 16GBの価値は「12B〜14B(Q4_K_M)が実用速度で載る」こと。qwen3:14bで7.4 tok/s、gemma3:12bで8.7 tok/s。8GB Nanoでは12B Q4はメモリに載らず実用外です(12B Q4の重みは約8GBで、8GB機の実効メモリを超えるため)。
- 快適さ重視なら8B以下。3B級で20〜26 tok/s、8Bで12.8 tok/s。会話用途の体感が良いのはこのレンジです。
- 20B超はGPUでは動かない。gpt-oss:20b・qwen3:30b-a3bはGPU/統合メモリへのロードでOllamaサーバーがクラッシュ(16GB超過とみられる)。CPU強制なら動くが1桁 tok/s で実用外です(後述)。
実測データ(Jetson Orin NX Super 16GB / ollama 0.34.0)
計測条件: warm・2回平均・num_predict=256・temperature=0・固定プロンプト。電力はtegrastats VDD_IN、温度はthermal_zone最大値。計測: 本サイト 2026-09-14。
| モデル | パラメータ | 量子化 | decode tok/s | TTFT | 電力 | 温度max |
|---|---|---|---|---|---|---|
| llama3.2:1b | 1.2B | Q8 | 50.3 | 33ms | 25.7W | 53℃ |
| qwen3.5:0.8b | 0.87B | Q8 | 41.6 | 78ms | 20.0W | 56℃ |
| qwen2.5vl:3b | 3.8B | Q4 | 25.7 | 56ms | 26.2W | 66℃ |
| qwen3.5:2b | 2.3B | Q8 | 25.1 | 79ms | 22.4W | 59℃ |
| llama3.2:3b | 3.2B | Q4 | 24.6 | 64ms | 25.6W | 59℃ |
| phi4-mini:3.8b | 3.8B | Q4 | 21.9 | 69ms | 27.6W | 65℃ |
| gemma3:4b | 4.3B | Q4 | 19.7 | 151ms | 24.7W | 61℃ |
| qwen2.5-coder:7b | 7.6B | Q4 | 13.6 | 97ms | 27.2W | 67℃ |
| qwen3:8b | 8.2B | Q4 | 12.8 | 102ms | 27.9W | 70℃ |
| gemma3:12b | 12.2B | Q4 | 8.7 | 400ms | 28.1W | 71℃ |
| qwen3:14b | 14.8B | Q4 | 7.4 | 163ms | 27.7W | 69℃ |
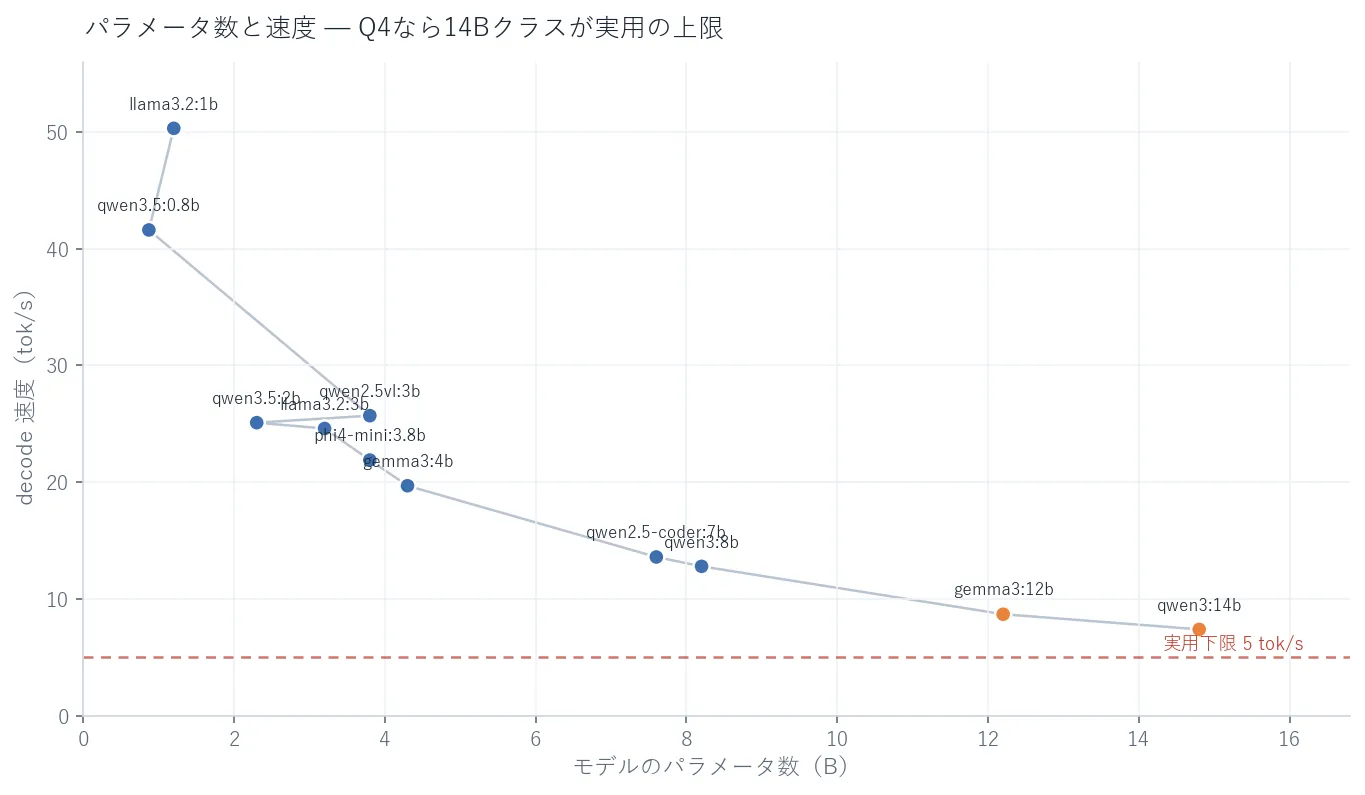
decode速度はパラメータ数にほぼ反比例し、14Bでも7.4 tok/sを維持します。文章生成の実用下限を「5 tok/s前後」と見るなら、この機材のQ4での実用上限は14Bクラスと言えます。温度は最大でも71℃、電力は20〜28Wの範囲で、MAXN_SUPERでも熱・電力に余裕がありました。
8GB Nanoとの違いは「容量」
Orin NX Super 16GBとOrin Nano Super 8GBは、GPU世代・メモリ帯域(ともにLPDDR5・102GB/s公称)が近い一方、メモリ容量が2倍です。ローカルLLMではこの容量差が「動く/動かない」を分けます。
- 3B〜8Bクラスは両機とも動きますが、12B・14B(Q4)は16GB機でのみ実用。8GB機は重みが載りきりません(厳密な可否は動くか判定ツールを参照)。
- カタログ観点・用途別の選び方はJetson vs Raspberry Pi 5も参考になります(Nano世代の選定軸を整理しています)。
限界域:20B・30Bは何が起きるか
16GBの上限を探るため、gpt-oss:20b(21B MoE, MXFP4)とqwen3:30b-a3b(30.5B MoE/アクティブ3B, Q4)も試しました。
- GPU/統合メモリ経路: どちらもロード時にOllamaサーバーがクラッシュ(プロセス切断→systemdが約3秒で自動再起動)。16GBの統合メモリにモデルが収まりきらない OOM(Out Of Memory=メモリ不足でプロセスが強制終了される状態) とみられます(クラッシュのため、失敗した段階の詳細までは取得できていません)。
- CPU強制(num_gpu=0・mmap・num_ctx=2048・num_predict=128): 稼働はするものの、gpt-oss:20bで4.6 tok/s、qwen3:30b-a3bで2.2 tok/s。実行経路も出力長も標準計測と異なる別プロトコルで、実用には遠い数値です。
つまり16GB機でも、20B超をGPUで快適に、というのは現状(ollama 0.34.0時点)では成立しません。詳細は動くか判定ツールの該当エントリに収録しています。
どちらを選ぶか
- 12B〜14BクラスのローカルLLMを実際に回したい → Orin NX Super 16GB。8GB機では届かないレンジが実用に入ります。
- 3B〜8Bで十分・省コスト重視 → 8GB Nanoでも足りることが多い(快適レンジは両機で重なる)。
- 20B超を狙う → 現状のエッジ単体(16GB)では非現実的。量子化・ランタイム進化待ち、または上位機材が現実解です。
自己レビュー(限界・要検証)
- 単体・単発の実測: 1台・各モデル2回平均の値です。個体差・サーマル・電源条件で変動し得ます。
- ランタイム依存: ollama 0.34.0での計測です。旧版(0.18.2)比で新アーキのGPUカーネル対応は版数依存で大きく変わり得ます(同系のNano機で、更新のみでLFM2.5が7.3倍高速化した前例があります)。将来版で20B超の挙動も変わる可能性があります。
- 8GB機の可否は容量からの推定: 本記事の「12B/14Bは8GBで載らない」は容量計算に基づく推定で、同一プロトコルでのNano実測との突き合わせは今後の課題です。
- カタログスペックの基準: Orin NX SuperのTOPS公称157は INT8 sparse(dense 78)で、Nano機の67と同じsparse基準です。
- CPU強制値は参考: 20B/30BのCPU数値は別プロトコル(num_predict=128)で、標準計測(256・GPU)と直接比較できません。