「ollamaは更新すると速くなる」とよく言われます。実際、本サイトの過去計測でも、Jetson系でLFM2.5が更新だけで7.3倍になった例があります。ではその高速化は、どんな機種・どんなモデルでも起きるのか——5機種で旧版0.18.2と新版0.34.0を同一条件で実測して確かめました。
結論
- GPU/Metal機では、主要モデルの速度に意味のある高速化はありません。Jetson・A6000・Mac mini M4・RTX 4060ノートで、llama3.2:3b / gemma3:4b / qwen2.5-coder:7b / qwen3:8b の4本を測って、平均は 1.00x / 0.97x / 0.97x / 0.99x。x86 CUDA機(A6000・RTX 4060)とMac miniはむしろ一部モデルで数%遅くなり(最大でMac miniのqwen2.5-coder:7bが−10%)、「更新で速くなる」実感は得られませんでした。
- CPUのみのRaspberry Pi 5だけ、一貫して小幅に速くなりました。4本すべてで速くなり、平均 +8.6%(各モデル+6〜約12%)。CPU推論の共通部分が新版で改善したためとみられます。
- 「7.3倍」のような劇的な高速化は、モデル固有の例外です。過去計測で見られた例で、旧版で新アーキのGPUカーネルが未最適だったためと推測され(本記事では再測定しておらず、カーネルレベルの検証も未実施)、汎用モデルには当てはまりません。
つまり 「更新すれば何でも速くなる」は誤解。速度目的の更新はCPU機でわずかに報われる程度で、GPU機では体感差はほぼありません。
実測データ(decode tok/s・0.18.2 → 0.34.0)
計測条件: 各機とも標準ollama配布物をスタンドアロン起動し、warm・2回平均・num_predict=256・temperature=0・同一プロンプト。数値はdecode速度(tok/s、大きいほど速い)。計測: 本サイト 2026-09-15。
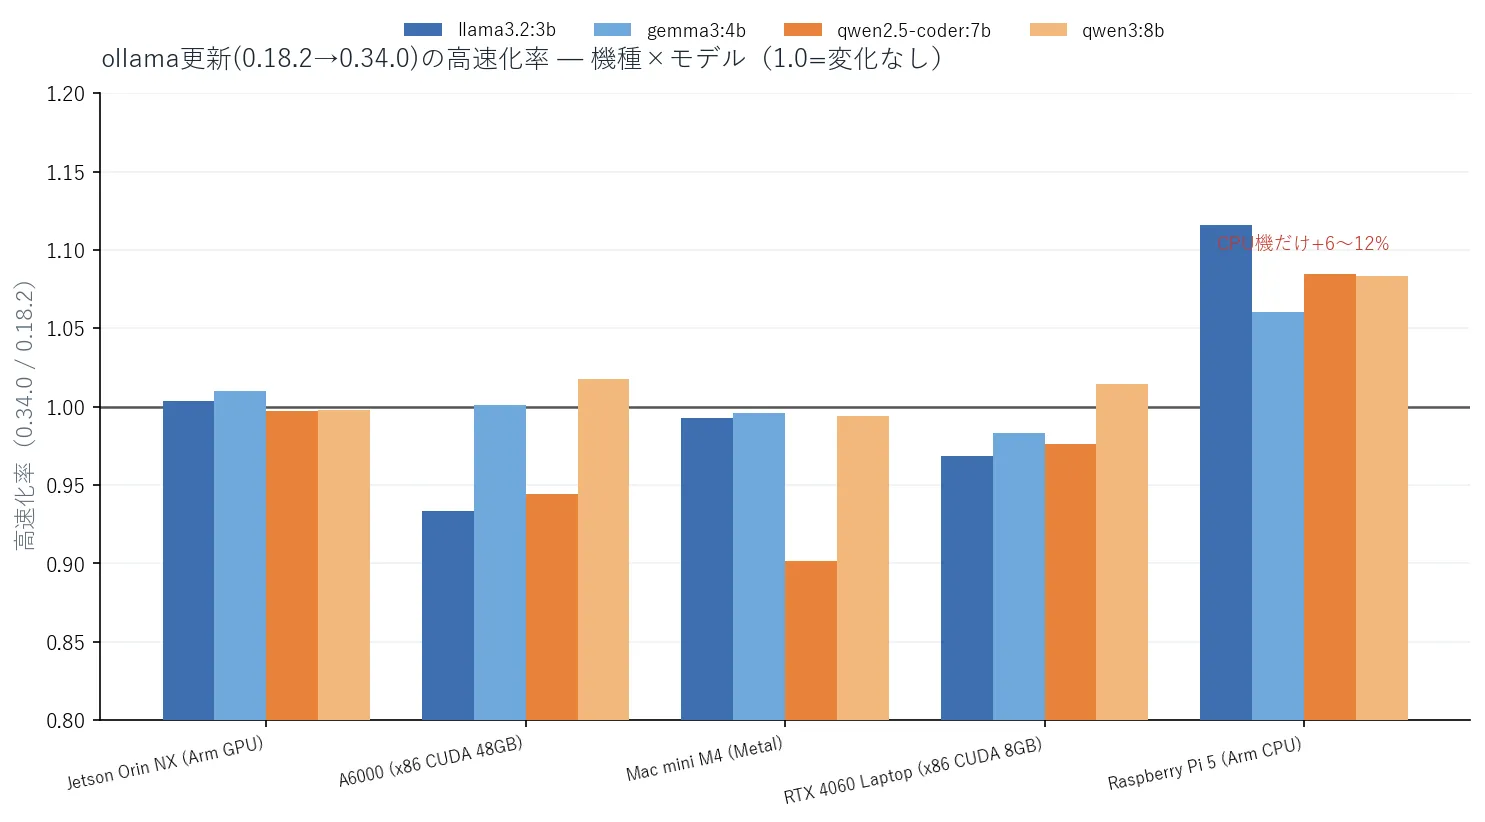
図: 高速化率(0.34.0 ÷ 0.18.2)。1.0が「変化なし」。GPU/Metalの4機は1.0前後(x86 CUDA機・Macは下振れ寄り)、CPUのPi5だけ全モデルで1.0超。
| 機種(推論経路) | llama3.2:3b | gemma3:4b | qwen2.5-coder:7b | qwen3:8b | 平均 |
|---|---|---|---|---|---|
| Jetson Orin NX(Arm GPU) | 1.00x | 1.01x | 1.00x | 1.00x | 1.00x |
| A6000(x86 CUDA 48GB) | 0.93x | 1.00x | 0.94x | 1.02x | 0.97x |
| Mac mini M4(Metal) | 0.99x | 1.00x | 0.90x | 0.99x | 0.97x |
| RTX 4060 Laptop(x86 CUDA 8GB) | 0.97x | 0.98x | 0.98x | 1.01x | 0.99x |
| Raspberry Pi 5(Arm CPU) | 1.12x | 1.06x | 1.08x | 1.08x | 1.09x |
GPU/Metalの4機は、いずれも平均1.0前後で意味のある高速化は見られません。むしろ x86 CUDA機(A6000・RTX 4060)とMac miniは4モデル中3〜4本が1.0以下で、幅は**−10%〜+2%と下振れ寄り**(最大の下振れはMac miniのqwen2.5-coder:7bで−10%)。ただし各モデル2回平均のため、この小幅な差が本物の微小な低下か測定のばらつきかは本データでは断定できません(多数回反復は今後の課題)。対してPi5は4モデルすべてで1.0を超え方向が揃っており、こちらは一貫した小幅改善とみられます。
なぜ機種で差が出るのか
ollamaの更新に含まれる高速化は、多くが「特定のモデルアーキテクチャ向けGPUカーネルの追加・最適化」です。
- 主要モデル(Llama・Qwen・Gemma系)は、旧版の時点でGPUカーネルが十分に効いていたためとみられ、今回の範囲では更新による伸びは見られませんでした。
- CPU実行は、共通ルーチンの改善が全モデルに薄く効いたためと考えられ、Pi5では一律に少し速くなりました(どの最適化が効いたかはコード差分までは追えていません)。
- 新しいアーキテクチャ(LFM2.5等)は、旧版だと未対応・非最適で桁違いに遅く、新版で正しいカーネルが入ると劇的に速くなる——「7.3倍」はこの類型とみられます(推測)。汎用モデルとは別物です。
更新すべきか(実務的な結論)
- 速度目的だけなら、GPU機は急いで更新しなくてよい(体感差なし)。CPU機は更新でわずかに速くなるので、やる価値はあります。
- 本当の更新理由は「速度」より「対応範囲」——新モデルの実行、バグ修正、セキュリティ、新機能(構造化出力・ツール呼び出し等)。新しいモデルを試したいなら更新は必須です(旧版では動かない/極端に遅いことがある)。
- 迷ったら更新して良い(副作用は小さい)。ただし「更新=速くなる」を期待しての作業なら、GPU機では肩透かしになります。
計測方法
- 版の選択: 0.18.2 は今回のJetsonに元々入っていた版で、それを最新0.34.0へ更新した「実際の差分」に相当します。他機も同じ0.18.2→0.34.0で揃えました。
- 各機で、公式配布のollama 0.18.2 と 0.34.0 を常用環境と別ポートでスタンドアロン起動(日常のollamaサービスは停止せず)。同一の固定プロンプト・num_predict=256・warm・2回平均でdecode速度を計測。
- 対象4モデルはいずれもollamaライブラリのQ4_K_M(llama3.2:3bとPi5一部はメモリ制約下でも完走)。
- 電力・温度は機種で計測経路が異なるため本記事では速度に絞って比較。
自己レビュー(限界・要検証)
- 各モデル2回平均・単発セッションです。GPU機の差(−10%〜+2%、下振れ寄り)は、x86 CUDA機(A6000・RTX 4060)とMacで小幅な低下方向に偏っており、本物の微小な退行か測定ばらつきかを本データでは区別できません(生の各実行のばらつきは未取得)。多数回反復での確認は今後の課題です。
- 5機種・4モデルの範囲での結論です。別モデル(特に新アーキ)や別の版ペアでは、CPU以外でも大きな差が出る可能性があります(LFM2.5の例)。
- **CPUの+8.6%**は4モデルで方向が揃った一貫改善ですが、要因(どの最適化が効いたか)はコード差分まで追えていません。
- RTX 4060ノートは、モデルpullが同機の低速回線を通ると計測が現実的でないため、モデルデータを別機からLAN経由で配置して計測しました(推論自体は同機のGPUで実行)。x86 CUDAの傾向はA6000と整合しました。